TabVer 基于自然逻辑的表格事实验证
原题:TabVer: Tabular Fact Verification with Natural Logic。作者:Rami Aly、Andreas Vlachos。TACL 2024,第 12 卷,1648–1671 页;对应 ACL Anthology 2024.tacl-1.89。
来源:论文页面;原始 PDF;官方代码。© 2024 Association for Computational Linguistics,CC BY 4.0。本中文学习译本由 AI 翻译并重新排版,未经作者审定,保留原作者、来源及许可。覆盖正文及方法和实验附录;参考文献原文见 references/TabVer_references.txt。页码指原 PDF,同时可与原刊页码相对照。“译注”不属于作者原话。
摘要
以表格为证据进行事实验证,促使研究者使用构建逻辑形式的符号推理模型,例如 LISP 风格程序;这比完全神经化的方法更容易核验。不过,这些逻辑形式通常依赖结构规整的表格,限制了应用。另一种面向文本证据的符号推理范式是自然逻辑推断:直接用自然语言表示主张与证据,通过集合论关系构建证明。它灵活、透明,但已有关系定义没有覆盖算术函数,因而难以处理表格证据。
我们在自然逻辑中给出数词和算术函数的集合论解释,将算术表达式整合进确定性证明。利用大语言模型针对主张关键部分生成问题,再在表格上使用适当函数回答问题,得到算术表达式。在 FEVEROUS 少样本场景中,准确率达到 71.4%,比最强神经或符号基线高 3.4 个百分点。无额外训练迁移至 TabFact 时,仍具有竞争力,准确率领先 0.5 个百分点。
1 引言
事实验证系统根据证据判断主张真伪,并解释预测。面对表格,常需要算术执行等符号步骤。将主张与表格映射成 LISP 程序等逻辑表示并执行,可以产生确定性判决,因此程序也成为忠实于决策过程的解释(Chen et al., 2020;Cheng et al., 2023;Jacovi & Goldberg, 2021)。但这些系统往往要求表格结构规整,难以处理维基百科上的多样表结构。许多新方法转向神经蕴含模型隐式进行运算,或生成自然语言解释;后者灵活,却不一定忠实反映模型的实际决策依据。
自然逻辑方法直接比较主张和文本证据的对齐片段,利用集合关系推理,在保留透明度的同时取得较好准确率(Angeli & Manning, 2014;Krishna et al., 2022;Aly et al., 2023)。但如果主张说“三个市镇”,表格只列出各市镇,自然逻辑关系不能直接完成计数。
TabVer 为自然逻辑增加算术能力。我们先定义主张和证据中的数词如何进行集合论比较,再将定义扩展到算术表达式(Arithmetic Expressions,ArithExps)。证明中的操作符序列交给确定性有限状态自动机(DFA)执行。语言模型针对主张关键片段生成问题,再依据表格产生推理依据和答案。例如,对“大于 12,000”生成“Ortegal 在 2018 年的总人口是多少”,将 3,945、1,126、1,363、5,804 求和,得到 SUM 12,238,再判断该答案与“大于 12,000”的自然逻辑关系。
只使用 FEVEROUS 的 64 条训练实例,TabVer 优于 LPA、SASP、Binder 和既有自然逻辑系统,亦优于同等规模的神经分类器。它可无额外 TabFact 标注地迁移,在复杂主张上有优势。数词探针表明,它对数值误差、限定词和舍入语境更敏感,也更符合 FEVEROUS 标注准则。作者还人工分析证明中调用的算术函数。图 1(p.2)展示主张片段、生成问题、抽取与运算,以及 DFA 证明之间的联系。
译注:引言称超越既有符号系统 10.5 点,但完整模型表 1 中 TabVer 71.4 与 Binder 62.7 相差 8.7 点;10.5 对应未分解 Binder 60.9 的比较。应指明比较版本。
2 相关工作
符号事实验证通常把文本转为 SQL/LISP 等逻辑形式,通过神经组件对手工候选排序或直接生成程序;代码生成能力提升又促成 SQL、Python 和一阶逻辑验证。部分研究依赖大型专有模型。本文在控制底层语言模型后比较,认为自然逻辑比查询语言更适合自然语言中的语义关系。
另一类方法把程序当作神经模型的特征,而不是直接由执行结果决定判决:例如使用 LISP 程序辅助图网络,或将 SQL 与执行结果输入语言模型分类器。Chain-of-Table 逐步修改证据表。思维链方法生成自然语言解释,但较小模型在表格事实验证上常接近随机;大规模表格指令微调则通常不生成忠实解释。已有方法因此常在大型模型依赖、准确率和解释性之间取舍。
自然逻辑 NatLog 直接对前提与假设中的语言片段建模集合关系,避免必须将整句转为刚性逻辑形式。近年的事实验证方法用问答表述自然逻辑操作符,以利用指令模型。本工作首次将这类自然逻辑事实验证扩展到表格。
表格问答也常被用来分解主张或补充证据。既有研究通过模板问题、表到文本模型或 LLM 分解得到信息,再交给神经分类器,但并不从答案构建可执行证明。文本领域的很多问题生成方法也没有这一证明环节。
3 方法
输入主张 c 与证据表集合 E,输出标签 ŷ∈{支持 Supports、反驳 Refutes、证据不足 NEI},并提供解释。证明 P=(m₁,…,mₗ) 由五元组 mᵢ=(cᵢ,eᵢ,qᵢ,aᵢ,oᵢ) 组成:cᵢ 是主张片段,eᵢ 是相关证据,qᵢ 是为该片段生成的问题,aᵢ 是通过算术计算得到的答案,oᵢ 是 cᵢ 与 aᵢ 间的自然逻辑关系 NatOp。
得到操作符序列 O=(o₁,…,oₗ) 后,最终标签 ŷ=DFA(O)。DFA 沿用 Angeli & Manning(2014)的文本蕴含自动机。图 2(p.4)中状态 S/R/N 分别为支持、反驳、证据不足;边表示自然逻辑操作符,最终状态决定判决。
我们先扩展数词关系定义,再扩展到算术表达式;问题生成模型 M_QG 为关键片段提问,问答模型 M_QA 抽取证据、产生运算与答案;证明模型 M_P 为片段—答案对赋关系,并沿用 QA-NatVer 从多个候选证明中选择的过程。
3.1 数词的集合论视角
研究数词关系时,考虑等价、前向蕴含、反向蕴含、否定和互斥五类关系;都不符合时为独立。很少出现的覆盖关系在实现中并入独立。
例如,“大约一百个进球”通常可由“99 个进球”支持,因为 about 扩大了一百所对应的数值集合,包括 99、101 等。没有修饰词的裸数词也有字面外的标量含义,其解读取决于语义与语用,常见解释包括“恰好”与“至少”,还受到向上蕴含或向下蕴含环境影响(Panizza et al., 2009)。自然逻辑通过环境投影显式建模这种影响。
多数主张处于向上蕴含环境,本文主要采用“恰好”的上界式解释;附录 A 讨论向下蕴含环境中的“至少”解释。例如恰好 2 个与恰好 5 个相互排斥,且并未覆盖所有自然数,所以分配互斥关系,而非严格的互补否定。
数词还存在“语用晕圈”(pragmatic halo):特定语境允许一定近似范围。社交媒体上的“某赛季进了 100 球”可能被 101 球的证据视为基本支持,因为 101∈{100}∪H₁₀₀;要求精确的科学文本则可令 H₁₀₀=∅。这里区别于被省略的“大约”等真值条件修饰语,也暂不讨论“恰好五点”仍可容忍毫秒偏差的情况。
晕圈一般随数值变大而扩大,但不只是固定百分比:英语十进制中,整十、整五数字通常更像舍入值。100 的近似容忍范围通常大于 101,因此“100 对 101”的可接受程度未必对称。这可通过投影到蕴含关系表示,并从人工证明标注学习。
图 3(p.5)给出例子:3 goals 与 three goals 等价;99 goals 可前向蕴含 scored about a hundred goals;2+ goals 相对 3 goals 为反向蕴含方向;5 goals 与 has scored two goals 互斥;3 goals 与 never scored three goals 互补否定。
3.2 算术表达式
当证据不直接包含验证所需的数值时,用 ArithExp 将相关表格内容映射为数词。函数 F:ℝⁿ→ℝ 输入证据 eᵢ,输出单个数值。答案表示为函数名与计算值的组合:Name(F) + F(eᵢ),例如 SUM 12,238。保留函数名很重要,因为 COUNT 5 与 COMP 5 的语义不同,会影响与主张片段的比较。
允许函数组合,如 F(G(Eᵢ),G(Eⱼ),…);对齐到主张的 ArithExp 用最终外层函数与最终结果表示。函数包括 count、sum、diff、average、min、max、比较和 copy。比较虽可用差值实现,但表示成独立类别,以表达隐式大小关系及显式差值;差的正负和绝对值分别携带方向与幅度。若相关信息已在单元格中,则使用 copy。图 4 中函数清单还写有 SUPER,原文未在本段进一步单列说明。
3.3 问题生成
M_QG(c,T) 读取主张和提示模板,联合自回归生成问题及对应主张片段,格式为 1. [q₁] [c₁] 2. [q₂] [c₂] …。用约束解码保证 cᵢ 是原主张的连续片段,也可以是整句,防止模型即使微调后仍插入原句没有的词;同时约束编号格式。后续问题以已有问题为条件,可提高信息覆盖并减少重复。
3.4 使用 ArithExp 的表格问答
M_QA 根据问题 qᵢ 和证据表 E 产生推理依据 J,包括:将相关单元格转换为文本得到 eᵢ;对 eᵢ 生成相关算术计算;得到答案 aᵢ。自回归概率分解为抽取证据 token 的条件概率乘积,以及随后生成运算 token 的条件概率乘积:
P(J|qᵢ,E) = ∏ᵤ Pθ(sᵤ|s<ᵤ,qᵢ,E) · ∏ₘ Pθ(fₘ|f<ₘ,qᵢ,eᵢ,E)。
不同部分采用不同约束:抽取阶段禁止生成表格中未出现的数字;计算部分必须先输出允许函数的触发词,例如 Adding 对应 sum,再接相关计算。最终 aᵢ 从生成依据中按规则构造成 ArithExp。图 4(p.6)给出人口求和过程,可抽取数字包括表中的年份与人口,触发词为 Adding,结果为 SUM 12,238。
若不需进一步运算,则抽取后输出 N/A,不返回算术表达式;若表中没有相关信息,则相关证据本身返回 N/A,映射到独立关系 #,使 DFA 输出 NEI。未单独提问的片段,例如年份,假定包含在其他问题抽取的证据里,由 QA-NatVer 的片段对齐算法与主张对齐。
译注:确定性 DFA 与答案格式构造,不应自动等同于所有上游抽取、数值计算和关系预测都已经被独立验证。
4 评价
4.1 数据
FEVEROUS。 只使用所有证据集合中的证据元素均为表格单元格的主张。这些主张复杂,表结构不规则。为专注验证组件,所有实验提供正确证据表,而不评价检索系统。评测子集含 2,011 条主张:支持 35%、反驳 61.7%、NEI 3.2%;其中 521 条涉及数值推理。训练从训练集均匀抽取 64 条,并人工补充推理依据、算术表达式和自然逻辑证明;标签及函数分布仍不均衡。
TabFact。 在 FEVEROUS 训练后直接迁移,无额外 TabFact 训练。该数据集只有支持与不支持两类;迁移时反驳和 NEI 合并为不支持。表格结构规整且首行为表头,也提供正确证据表。本文使用开发集 12,851 条,标签均衡,其中简单 R1 为 4,424、复杂 R2 为 8,427。
译注:12,851 是本论文所报告的开发集口径,与原始 TabFact 论文的过滤后验证集 12,792 不同,引用时应注明版本,不自行改数。
4.2 基线
第一类为不提供符号机制或解释的分类模型:在多个 NLI 数据集微调的 DeBERTaV3、通过表格操作继续预训练的 PASTA、具有表格感知位置嵌入的 TAPAS、预训练为 SQL 执行器的 TAPEX,以及 LoRA 微调的 Llama2-Chat-7B、MistralOrca-7B。编码模型联合训练到真伪标签的线性映射。
第二类为输出可执行解释的符号模型:LPA 使用手工函数和触发词搜索程序再排序;SASP 使用词汇与结构特征约束候选,以 TaBERT 和 LSTM 生成程序;Binder 将主张转为包含模型 API 的 SQL。为与 TabVer 控制比较,Binder 的底层模型改为 MistralOrca-7B。找不到可执行程序时,上述模型回退为 NEI/不支持。QA-NatVer 将自然逻辑关系转换成问答,使用 Flan-T5-3B,表格先线性化。
4.3 实现细节
主张分解。 FEVEROUS 的证据只要求足以得出判决,并不保证覆盖陈述的每个部分。被反驳的复合主张可能缺失其他部分证据,直接整体推理会误报 NEI。我们训练 M_D 将主张分成可独立理解的原子子主张,标注来自相同 64 条训练实例。
合并规则为:全部子主张支持则支持;任一子主张反驳则反驳;其余情况为 NEI。聚合本身是确定性的。所有符号基线使用同样分解以保持可比;分类基线输入原始主张,因为分解可能引入传播错误,且不完整证据对其预期影响较小。图 5(p.12)展示分解与判决聚合。
训练设置。 遵循真实少样本场景,不使用验证集调参。M_QG、M_QA、M_D 为 LoRA 微调的 MistralOrca-7B。证明模型 M_P 沿用 QA-NatVer,并全参数微调 Flan-T5-3B 或较小的 BART0(406M)比较规模。当前证明模块实现只支持编码器—解码器;生成问题和答案与判别自然逻辑关系的需求也不同,后者在该规模下仍适合编码器—解码器。替代架构留待未来研究。主结果为五次运行的均值与标准差;未另说明的实验采用种子 42。
5 结果
FEVEROUS
表 1(p.9)同时报告准确率和宏平均 F1,以反映类别不平衡。下表 均值±标准差,数值均为百分比:
宽表格可左右滑动查看
| 方法 | 全集准确率 | 全集宏 F1 | 数值子集准确率 | 数值子集宏 F1 | 找到程序或证明 |
|---|---|---|---|---|---|
| 多数类 | 61.7 | 20.5 | 64.8 | 21.6 | — |
| DeBERTaV3 | 53.9±0.7 | 36.8±0.4 | 55.6±0.6 | 36.0±1.3 | — |
| PASTA | 54.6±2.8 | 34.1±0.4 | 55.3±4.3 | 32.6±1.4 | — |
| TAPAS | 53.6±7.6 | 35.9±4.1 | 52.9±7.3 | 33.8±3.4 | — |
| TAPEX | 53.6±1.5 | 34.0±0.9 | 52.8±3.4 | 32.9±2.1 | — |
| Llama2-Chat-7B | 56.0±4.0 | 30.9±1.6 | 55.0±6.1 | 30.9±2.5 | — |
| MistralOrca-7B | 68.0±1.1 | 45.4±4.4 | 64.5±3.2 | 43.6±3.0 | — |
| LPA 无分解 | 31.6±0.4 | 27.5±0.5 | 37.3±0.7 | 28.1±0.9 | 54% |
| LPA | 21.8±0.1 | 21.4±0.2 | 22.3±0.4 | 21.3±0.4 | 41% |
| SASP 无分解 | 52.9±2.6 | 29.8±1.8 | 55.1±3.4 | 29.3±1.9 | 98% |
| SASP | 58.8±0.8 | 29.6±0.8 | 61.5±1.2 | 29.4±0.8 | 95.2% |
| Binder 无分解 | 60.9±1.2 | 38.0±1.3 | 61.0±1.6 | 40.1±2.2 | 95.7% |
| Binder | 62.7±1.4 | 37.3±1.3 | 63.7±1.8 | 39.3±1.6 | 95.4% |
| QA-NatVer | 54.0±1.1 | 34.8±0.2 | 52.6±1.6 | 28.9±0.3 | 100% |
| TabVer BART0 | 69.9±0.3 | 49.4±0.9 | 66.7±0.3 | 42.4±0.8 | 100% |
| TabVer FlanT5-xl | 71.4±0.5 | 51.0±0.5 | 70.1±1.3 | 45.8±0.3 | 100% |
TabVer 在全集和数值子集分别超过最强基线 3.4 和 5.6 个准确率点,全集宏 F1 高 5.6 点。除 MistralOrca 外,分类基线在 64 条少样本下表现较差,Llama2 的弱表现也与既有研究一致。作为数据效率对照,在 18,836 条表格 FEVEROUS 训练实例上充分训练 TAPAS,可达到 73.0%,只比 TabVer 高 1.6 点。
LPA 等结构化程序系统难以处理嵌套表头和不规则结构。LPA 分解版本只为 41% 主张找到程序;神经引导的 SASP、Binder 覆盖率较高,但准确率仍较低。QA-NatVer 由于操作自然语言而有 100% 证明覆盖,却难以正确对齐表格及进行算术推理。程序型系统在数值子集上可与全集相当或更好,很多分类与自然逻辑方法则相反,反映复杂文本的意义表示仍困难。
译注:原文接着称 LPA 在找到程序的案例上为 55.8,并称比“整体”高 25.6;该差值与表 1 中 21.8 并不直接相符,不能据此重算出另一个未报告结果。
TabFact 跨域迁移
表 2(p.10)如下,五次运行的标准差与原表一致:
宽表格可左右滑动查看
| 方法 | 全集准确率 | 全集宏 F1 | R1 准确率 | R2 准确率 |
|---|---|---|---|---|
| LPA 在 TabFact 全监督 | 65.2 | 64.2 | 77.6 | 57.4 |
| SASP 在 TabFact 全监督 | 74.7 | 74.7 | 86.1 | 68.9 |
| TAPAS 在 TabFact 全监督 | 82.1 | 82.0 | 92.8 | 76.5 |
| DeBERTaV3 迁移 | 50.7±0.4 | 49.7±1.3 | 50.8±0.7 | 50.6±0.2 |
| PASTA 迁移 | 50.4±0.6 | 46.1±5.6 | 50.6±1.1 | 50.4±0.5 |
| TAPAS 迁移 | 53.9±5.9 | 53.0±6.8 | 58.8±10.6 | 51.3±3.6 |
| TAPEX 迁移 | 49.7±4.3 | 44.3±5.1 | 49.5±3.4 | 49.8±2.9 |
| Llama2 迁移 | 51.2±1.6 | 47.3±4.2 | 51.5±2.5 | 51.1±0.8 |
| MistralOrca 迁移 | 60.6±3.1 | 58.1±6.0 | 67.2±4.2 | 57.2±2.6 |
| LPA 迁移 | 59.4±1.4 | 57.9±1.4 | 70.4±2.5 | 53.8±0.9 |
| SASP 迁移 | 48.7±2.8 | 45.1±2.9 | 50.7±3.0 | 47.7±3.0 |
| Binder 迁移 | 65.1±1.0 | 65.1±1.0 | 76.9±0.6 | 59.1±1.3 |
| QA-NatVer 迁移 | 50.9±0.1 | 43.6±0.3 | 52.7±0.2 | 49.9±0.1 |
| TabVer BART0 | 62.8±0.8 | 62.3±0.9 | 71.1±1.0 | 58.6±0.6 |
| TabVer FlanT5-xl | 65.6±0.3 | 64.8±0.6 | 72.6±0.5 | 62.1±0.4 |
同表 R1、R2 的宏 F1 为:
| 方法 | R1 宏 F1 | R2 宏 F1 |
|---|---|---|
| LPA 全监督 | 77.5 | 55.6 |
| SASP 全监督 | 86.1 | 68.9 |
| TAPAS 全监督 | 92.8 | 76.4 |
| DeBERTaV3 | 49.5±1.7 | 49.8±1.1 |
| PASTA | 46.4±6.1 | 45.9±5.4 |
| TAPAS | 58.5±11.3 | 49.9±4.7 |
| TAPEX | 47.6±3.8 | 43.3±2.9 |
| Llama2 | 47.8±4.3 | 47.0±4.2 |
| MistralOrca | 65.9±5.8 | 53.3±6.4 |
| LPA | 70.3±2.5 | 50.2±1.0 |
| SASP | 47.5±2.0 | 43.8±3.7 |
| Binder | 76.9±0.6 | 59.1±1.3 |
| QA-NatVer | 49.8±0.1 | 49.1±0.2 |
| TabVer BART0 | 71.1±1.1 | 57.5±0.9 |
| TabVer FlanT5-xl | 72.2±0.6 | 60.8±0.9 |
TabVer 准确率领先 Binder 0.5 点,但宏 F1 低 0.3 点。规整表格对 LPA、SASP、Binder 更友好,三者可执行率分别为 78%、99.8%、100%。Binder 简单主张更强,TabVer 在复杂主张上更强。完整监督 TAPAS 在 92,283 条训练数据上达 82.1,明显高于迁移系统;只有 64 条 FEVEROUS 样本不足以让这些分类器学习任务映射。TabVer 与全监督 LPA 相近,但仍落后全监督 SASP 9.1 点。因此这里评价的是迁移与少样本能力。
数词解读
作者从支持类中构造数值扰动探针,包括误差、舍入、about 等修饰词、at most/at least 等数量限定词。总计 1,638 条,构造细节见附录 D。表 3 报告“原先正确预测为支持,修改后仍保持支持”的比例,而非准确率:
| 修改方式 | Mistral 分类器 | Binder | TabVer |
|---|---|---|---|
| 加 1 | 63.4% | 57.7% | 36.3% |
| ±2% | 42.7% | 38.4% | 29.1% |
| ±10% | 37.8% | 38.4% | 26.3% |
| ±25% | 31.7% | 51.9% | 23.6% |
| 舍入 | 33.3% | 47.4% | 30.3% |
| 加近似修饰词 | 40.6% | 56.4% | 57.0% |
| 错误数量限定词 | 32.9% | 53.8% | 31.8% |
| 正确数量限定词 | 37.8% | 78.8% | 49.1% |
TabVer 对微小数值错误更敏感,符合 FEVEROUS 对无修饰数词要求精确一致的准则;加入近似修饰词时又更常保留支持。分类器不能很好区分正确与错误的数量限定词;Binder 与 TabVer 能区分,但 Binder 的答案偏置投票整体更偏向支持。译注:本段原文解释句把加 1 情形的 Binder 与分类器数值顺序说反,表格如上保留。
算术表达式正确性
随机选取 160 条 FEVEROUS 主张,人工标注得出正确判决所需的函数,比较最终证明中的调用。表 4(p.11):
| 函数 | LPA | Binder | TabVer |
|---|---|---|---|
| 整体 | 43.8 | 76.5 | 76.0 |
| 筛选或复制 | 41.7 | 85.6 | 90.4 |
| 比较 | 33.3 | 0.0 | 25.0 |
| 计数 | 75.0 | 85.7 | 46.4 |
| 求和 | 0.0 | 100.0 | 100.0 |
| 差值 | 0.0 | 0.0 | 16.6 |
| 最小或最大 | 0.0 | 0.0 | 0.0 |
TabVer 整体显著好于 LPA,与 Binder 相近;Binder 计数更好,TabVer 比较更好。函数类别样本量见附录 B,不能仅凭 100% 判断所有求和任务可靠。
消融
表 5(p.11,种子 42):
宽表格可左右滑动查看
| ArithExp | 约束解码 | 抽取依据 | 主张分解 | 全集准确率 | 数值准确率 |
|---|---|---|---|---|---|
| 有 | 有 | 有 | 有 | 72.0 | 71.4 |
| 有 | 无 | 有 | 有 | 69.2 | 66.2 |
| 无 | 无 | 有 | 有 | 66.1 | 61.0 |
| 无 | 无 | 无 | 有 | 60.9 | 59.9 |
| 有 | 有 | 有 | 无 | 66.3 | 63.7 |
| 无 | 无 | 无 | 无 | 44.6 | 43.0 |
去掉算术表达式,数值子集下降约 10 点;进一步去掉证据抽取、改回整表线性化,则表现接近 QA-NatVer。证据抽取对非算术主张同样重要;去掉主张分解降低表现,并使长主张更容易输出 NEI。译注:66.3 并不低于多数类 61.7,原文“去掉分解后低于多数类”的笼统文字与该行有出入;全去除的 44.6 才低于多数类。
6 局限
TabVer 增加算术能力,但没有改变自然逻辑的组合蕴含系统和 DFA。NatLog 的演绎能力弱于一阶逻辑,某些量词的德摩根规律等无法直接推导。TabVer 可在证明中显式加入算术和分解,也可能在片段关系预测中隐式处理推理。
例如从“不是所有鸟都会飞”推出“有些鸟不会飞”,最细粒度的可行证明仍可能先把“Not all”与“Some do not”视为整体等价。这样证明执行忠实,却没有解释这一关系本身如何得出。因此 TabVer 的证明并不一定是对全部推理过程的完整说明。
证明也不能给同一片段分配 cat→dog→poodle 这样的多步关系链,限制了超出算术的多表、多跳组合。实现按从左到右执行,然而自然逻辑本身的组合并非固定唯一顺序;改变关系顺序可能产生信息量不同的最终标签。一个已经包含错误子事实的复合陈述,后续关系可能把反驳转为 NEI。
TabVer 用主张分解避免过长证明,同时考虑不同粒度候选证明缓解问题。例如将“市镇数量”和“总人口”拆开,分别推理后用确定性规则合并,避免多个错误与独立关系叠加引起 NEI。它们是缓解机制,并未使自然逻辑变成完备的通用定理系统。
7 结论
本文提出为自然逻辑增加算术推理的 TabVer,用少量训练样本完成表格事实验证。通过主张数词与算术答案的集合论关系,结合主张感知问题生成、依据引导问答与约束解码,生成可整合入证明的算术表达式。在 FEVEROUS 与 TabFact 迁移场景中取得有竞争力的结果,并显示对数词语境更细致的区分。未来将研究不同数值精度要求的数据集上的标量含义与自然逻辑。
致谢:研究获 EPSRC 博士培养项目及 ERC AVeriTeC 项目支持;作者感谢就语言学概念、论文反馈提供帮助的同事、匿名审稿人与责任编辑 Kenji Sagae。
附录 A 方法细节
| 关系 | 集合定义 |
|---|---|
| 等价 EQ | x=y |
| 前向蕴含 FWD | x⊂y |
| 反向蕴含 REV | x⊃y |
| 否定 NEG | x∩y=∅ 且 x∪y=U |
| 互斥 ALT | x∩y=∅ 且 x∪y≠U |
| 独立 IND | 其他情况 |
自然逻辑用投影 ρ:O→O 处理语言环境。向上蕴含默认为恒等投影;向下蕴含通常交换前向与反向关系,并将互斥投影为覆盖。数词“至少”解读还会进一步改变投影。例如“凡进至少 3 球的人都得奖金”蕴含“凡进至少 4 球的人都得奖金”。原文表 7(p.19)给出完整符号映射;为避免稀有逻辑符号混淆,原页见 表 6 和表 7。
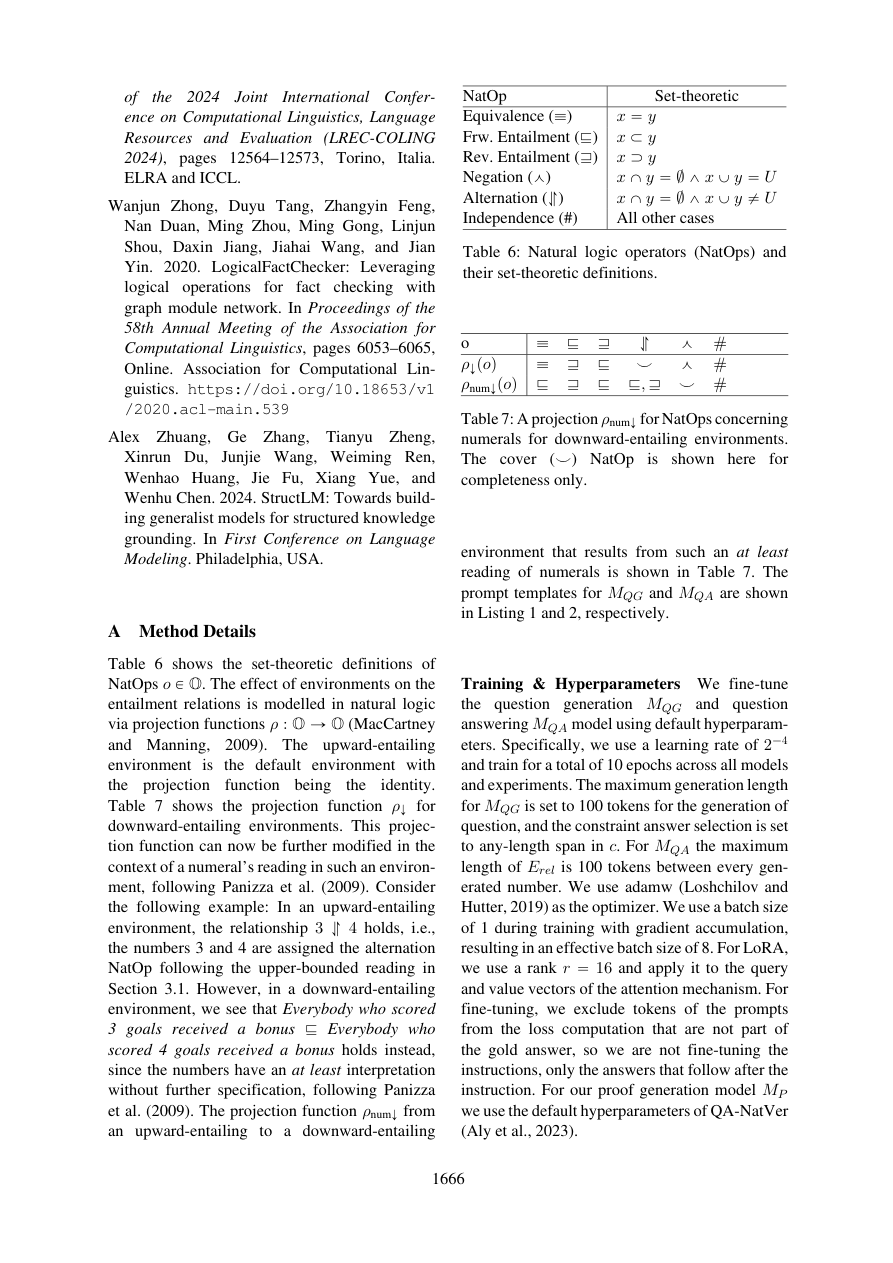
超参数。 问题生成与问答模型训练 10 个 epoch,AdamW,学习率原文印作 2⁻⁴;训练 batch=1,梯度累积后有效 batch=8。LoRA rank=16,作用于注意力 query 和 value。问题最多生成 100 token,所选主张片段长度不限;问答中每两个数字之间的证据文本最多 100 token。损失只计算答案部分,不训练提示本身。证明模型沿用 QA-NatVer 默认设置。
译注:2⁻⁴ 与常见 2×10⁻⁴ 并不是同一个值,原文版面为前者;不可无说明替换为后者,复现须核对配置。
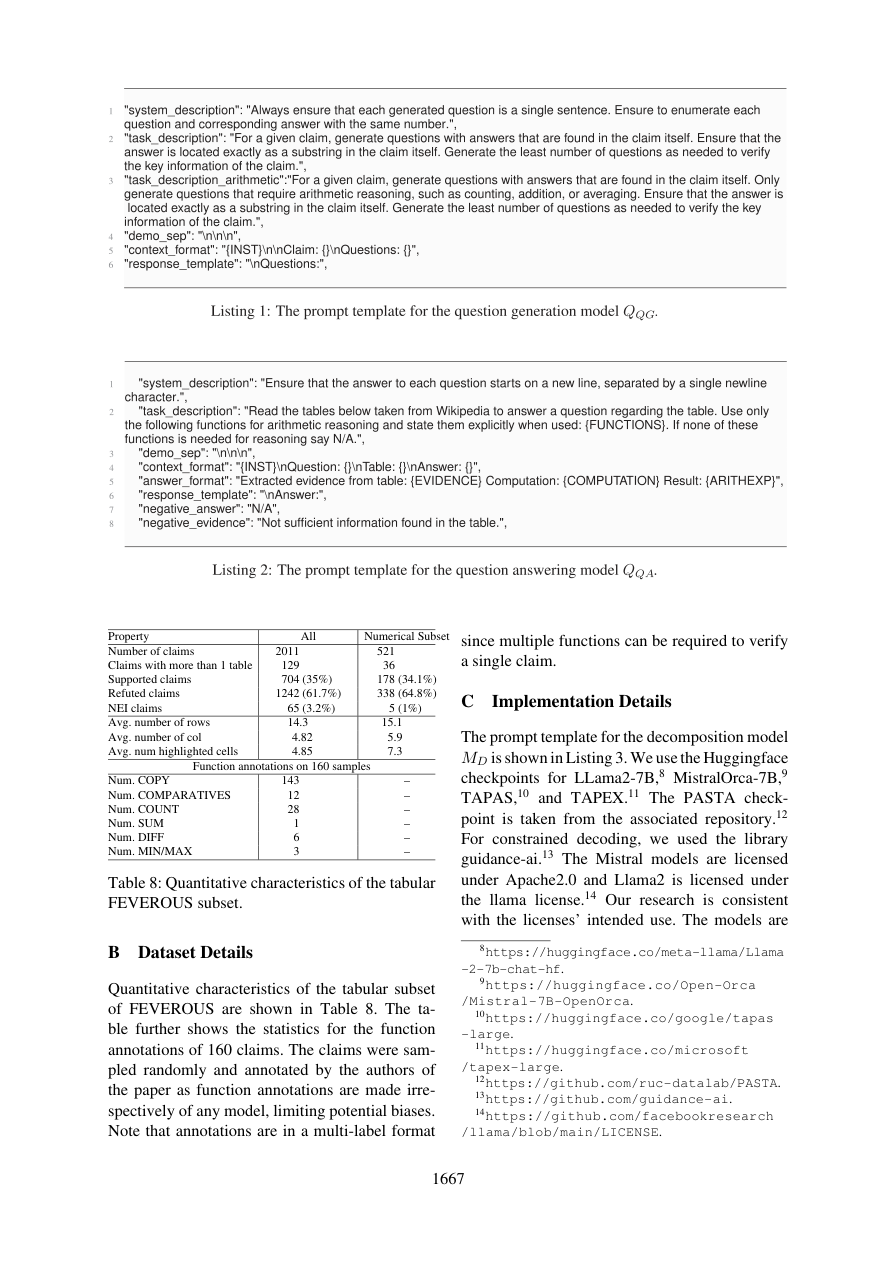
问题生成提示译文。 每个问题必须是单句,问题和答案采用相同编号。针对主张生成问题,答案必须精确位于原主张的一个子串中,使用尽可能少的问题覆盖关键事实。算术版本另要求只生成计数、相加或平均等需要算术推理的问题。
问答提示译文。 逐行回答问题;读取来自维基百科的表格,只使用给定函数进行算术推理,使用时明确写出;不需运算则写 N/A。输出格式为“表中提取的证据:{EVIDENCE};计算:{COMPUTATION};结果:{ARITHEXP}”。没有足够信息时说明表格信息不足。
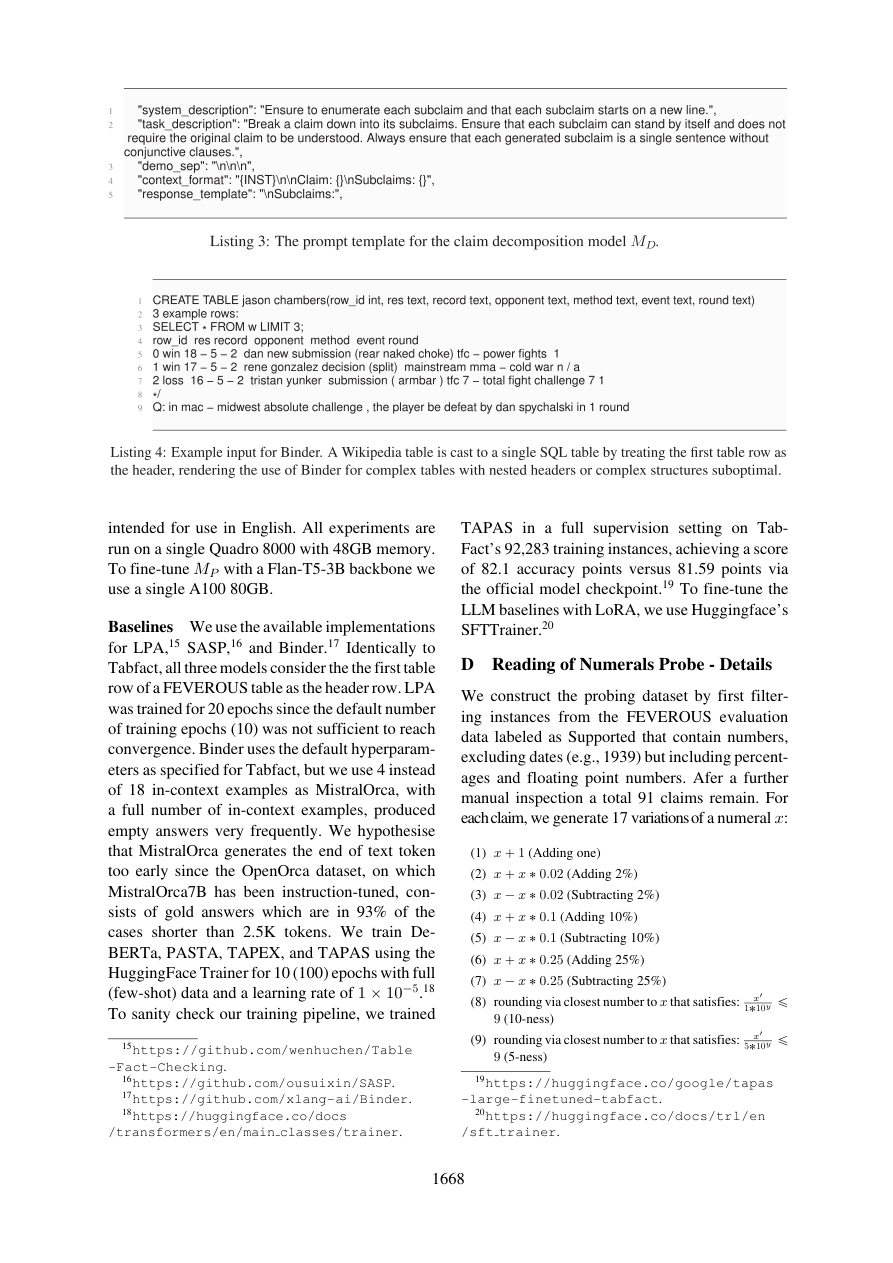
分解提示译文。 将主张拆成编号子主张,每条单独一行;子主张可独立理解,不依赖原句,且必须是单句,不能包含合取子句。原始模板见 p.20 与 p.21。这些译文便于理解,复现实验应使用原英文提示。
附录 B 数据细节
| 性质 | 全集 | 数值子集 |
|---|---|---|
| 主张 | 2,011 | 521 |
| 多于一张证据表 | 129 | 36 |
| 支持 | 704(35%) | 178(34.1%) |
| 反驳 | 1,242(61.7%) | 338(64.8%) |
| NEI | 65(3.2%) | 5(1%) |
| 平均行数 | 14.3 | 15.1 |
| 平均列数 | 4.82 | 5.9 |
| 平均高亮证据格 | 4.85 | 7.3 |
160 条人工函数标注为多标签:COPY 143、比较 12、COUNT 28、SUM 1、DIFF 6、MIN/MAX 3。同一主张可能需要多个函数,因此计数不加总为 160。由作者随机抽样后标注,标注不针对特定模型结果,旨在降低偏差。
附录 C 实现与基线
使用 Hugging Face 的 Llama2-Chat-7B、Mistral-7B-OpenOrca、TAPAS-large、TAPEX-large;PASTA 来自官方仓库。约束解码用 guidance-ai。模型主要面向英语。一般实验在单张 48GB Quadro 8000 上完成,Flan-T5-3B 证明模型微调用单张 80GB A100。
LPA、SASP、Binder 使用官方实现,并都将表首行视为表头;因此嵌套表头可能被错误处理。LPA 默认 10 epoch 未收敛,改为 20。Binder 因 MistralOrca 在长提示下经常提前输出终止符,使用 4 而不是 18 个上下文示例;作者推测与其指令数据中多数答案较短有关。
DeBERTa、PASTA、TAPAS、TAPEX 在全量/少样本条件分别训练 10/100 epoch,学习率 10⁻⁵。作为训练管线检查,TAPAS 在 TabFact 全监督获得 82.1,对照官方 checkpoint 的 81.59。LLM 的 LoRA 微调使用 Hugging Face SFTTrainer。
附录 D 数词解读探针
先从评测集支持主张中筛出含数字但非年份的样本,包含百分数和浮点数;人工检查后剩 91 条。每条生成 17 个数值变体,并保留原句,共 91×18=1,638 条:加 1;分别加减 2%、10%、25%;按整十、整五、2.5 倍形式舍入;对三类舍入分别加 about/around/approximately;在减少 10% 的数前加 at most 或增加 10% 的数前加 at least 构造错误限定;反向组合构造正确限定。
舍入遵循 Jansen & Pollmann(2001)关于常见圆整数形式的观察,例如 1000 通常比 1010 更自然。主表中的各行对对应变体取平均:±2%、±10%、±25%,三种舍入、三种近似修饰、两种错误数量限定及两种正确数量限定。实验用于探查模型数词解读行为,不是独立构建大规模新主张测试集。
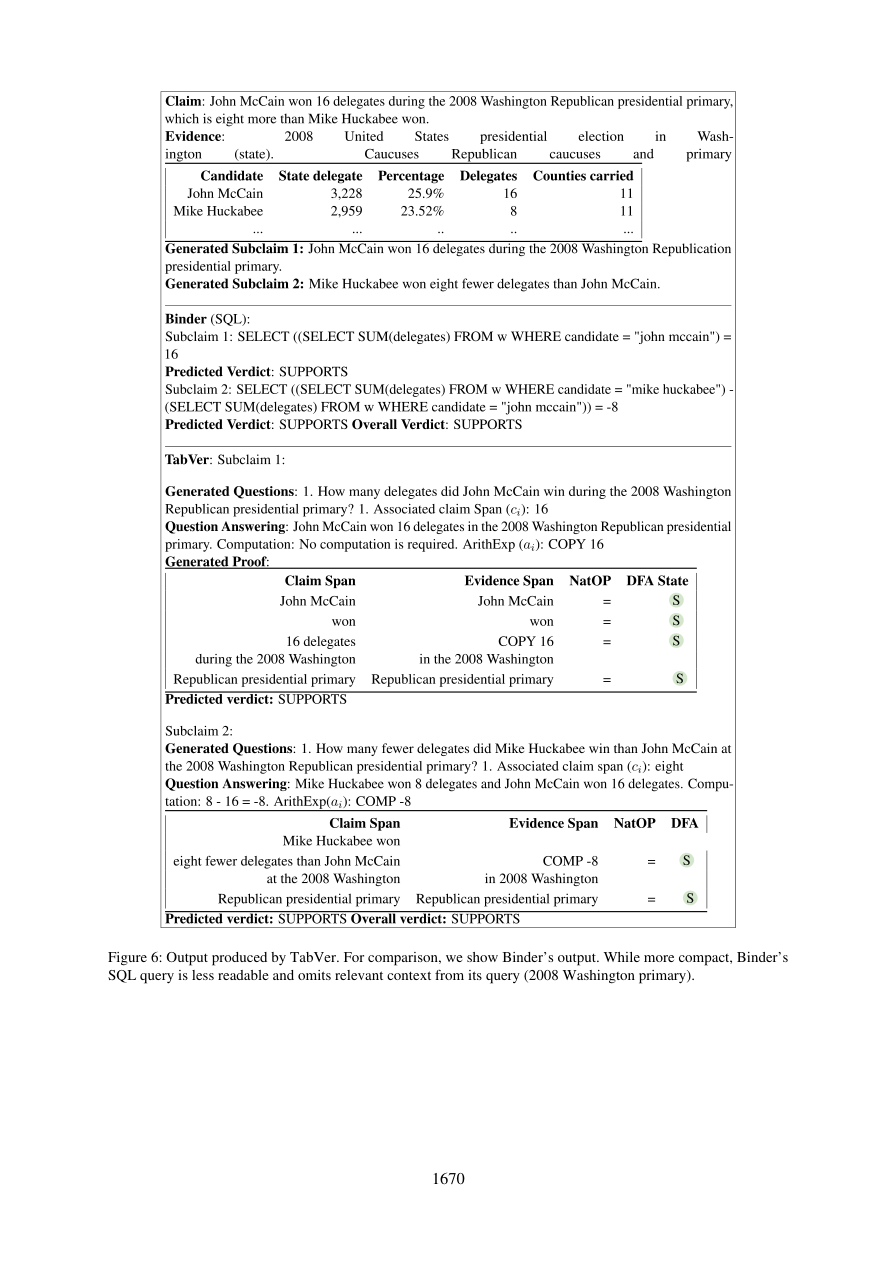
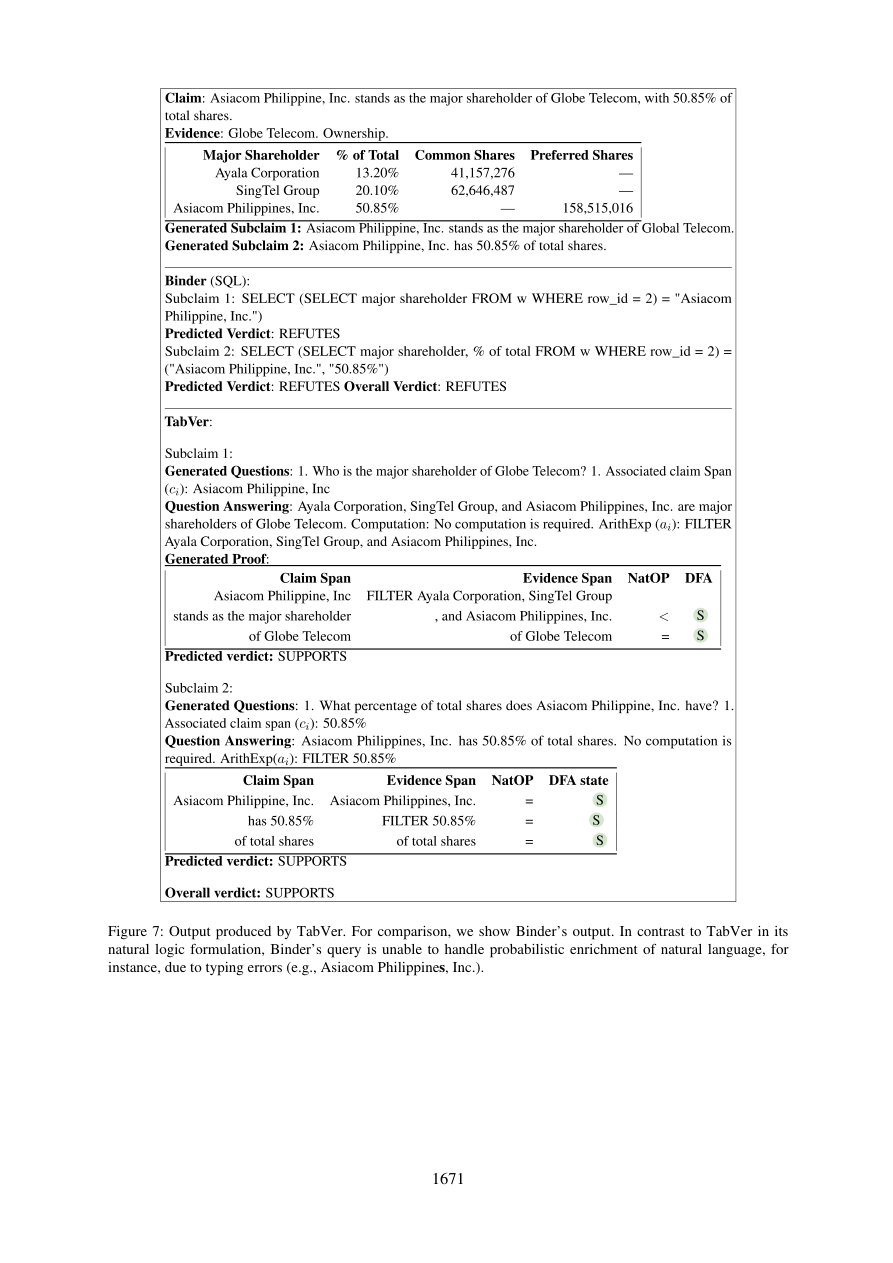
附录图 6、7(原 PDF pp.23–24)比较 TabVer 与 Binder 输出:前者自然语言证明更可读,保留背景语境;后者 SQL 更紧凑,却可能遗漏相关上下文或无法处理拼写差异。原图可见 图 6、图 7。
湘ICP备2026051447号